
MS Paint リドロー — バイラル GPT Image 2 落書きプロンプト
どんな写真でもアップロードして生成を押すだけ — GPT Image 2 が「下手で情けない」MS Paint 落書きとして描き直します。
ネットサーフィン中に見かけたバズりプロンプトがプリセット済。コピペ不要、いじる必要なし — 画像 1 枚を投入するだけ。
The Clumsy, Scribbly, Pathetic な MS Paint プロンプト
これがバイラルになった GPT Image 2 プロンプトの全文(一字一句そのまま): "Redraw the attached image in the most clumsy, scribbly, and utterly pathetic way possible. Use a white background, and make it look like it was drawn in MS Paint with a mouse. It should be vaguely similar but also not really, kind of matching but also off in a confusing, awkward way, with that low-quality pixel-by-pixel feel that really emphasizes how ridiculously bad it is. Actually, you know what, whatever, just draw it however you want." このページ上部のジェネレーターにすでにプリセット済 — コピペは不要です。上の文言をそのまま使えば、clumsy MS Paint style image redraw をどこでも実行できます。
なぜ "clumsy, scribbly, pathetic" が効くのか
この 3 つの単語こそ仕掛けのすべて。GPT Image 2 に「きれいに仕上げる」のをやめる許可を与え、いつもの整った絵ではなく badly drawn なマウス×MS Paint の見た目へ振り切らせます。
なぜ白背景なのか
"Use a white background" が照明と奥行きを削ぎ落とし、結果がレンダリングされたイラストではなく平面的な MS Paint の落書きとして読めるようになります — まさにこのトレンド特有の落書き美学です。
なぜ最後の「投げやりな一文」なのか
"Whatever, just draw it however you want" がモデルの正確さへのこだわりを緩め、人々がスクショして拡散する、あの的外れで紛らわしく、笑えるほど下手な描き直しを生み出します。
MS Paint リドロー プロンプトとは?
ある晩ネットを巡回していて見つけた、添付画像を「できるだけ下手で、落書きで、完全に情けない方法で」描き直すよう求める GPT Image 2 プロンプト。一気にバズりました。出力は意図的に下手で笑える — 元と何となく似ているが、明らかにマウスで描いた子どもの絵。本ページはまさにそのプロンプトを GPT Image 2 の image-to-image モードに繋ぎ、自分の写真からワンクリックで実行できるようにします。
そのバイラルプロンプトをプリセット
コピペ不要、編集不要。話題になったその文言が編集フォームにすでにロード済 — 画像をアップロードして生成を押すだけ。
image-to-image、テキスト→画像ではない
プロンプトは *添付された* 画像を描き直します — テキスト→画像で実行すると無関係な落書きが出るだけ。ミーム本来の動きを再現するため image-to-image を既定に。
GPT Image 2 ベース
バズった元ネタと同じモデル。GPT Image 2 は、認識可能な構図を保ちながら意図的にひどいピクセル感を実現 — 笑いを成立させる秘訣。
あなたのもの、シェアして
結果をダウンロード、X に投稿、友人に送信、プロフィール写真にも。出力は標準 PNG — 有料プランではウォーターマークなし。
Clumsy MS Paint Style Image Redraw を手に入れる方法
普通の写真から badly drawn な MS Paint 落書きまで、3 クリックで。clumsy で落書きなプロンプトはすでにロード済なので、コピーするものは何もありません。
写真をアップロード
どんな画像でも投入 — 人物、ペット、風景、スクリーンショット。元がくっきりしているほど badly drawn な描き直しが笑えます。ページはすでに image-to-image モードなので、あなたの写真が描き直しの対象になります。
clumsy な MS Paint プロンプトはプリセット済
コピペ不要。あの "clumsy, scribbly, and utterly pathetic" な GPT Image 2 プロンプトがそのままボックスに入っています。そのまま使うもよし、"MS Paint" を "crayon" や "a 4-year-old's drawing" に置き換えて別の下手アートスタイルにするもよし。
生成・ダウンロード・シェア
生成を押せば GPT Image 2 があなたの写真を clumsy MS Paint style image redraw として返します — ツイート・iMessage・Discord サーバーにそのまま投下できるクリーンな PNG です。
実際にどう見える?
上のプロンプトを GPT Image 2 で実行した 9 つのリアル Before/After — 人物、ペット、料理、集合写真、名所、名画まで。同じエンジン、同じ文言 — あなたの写真も同じ扱いを受けます。
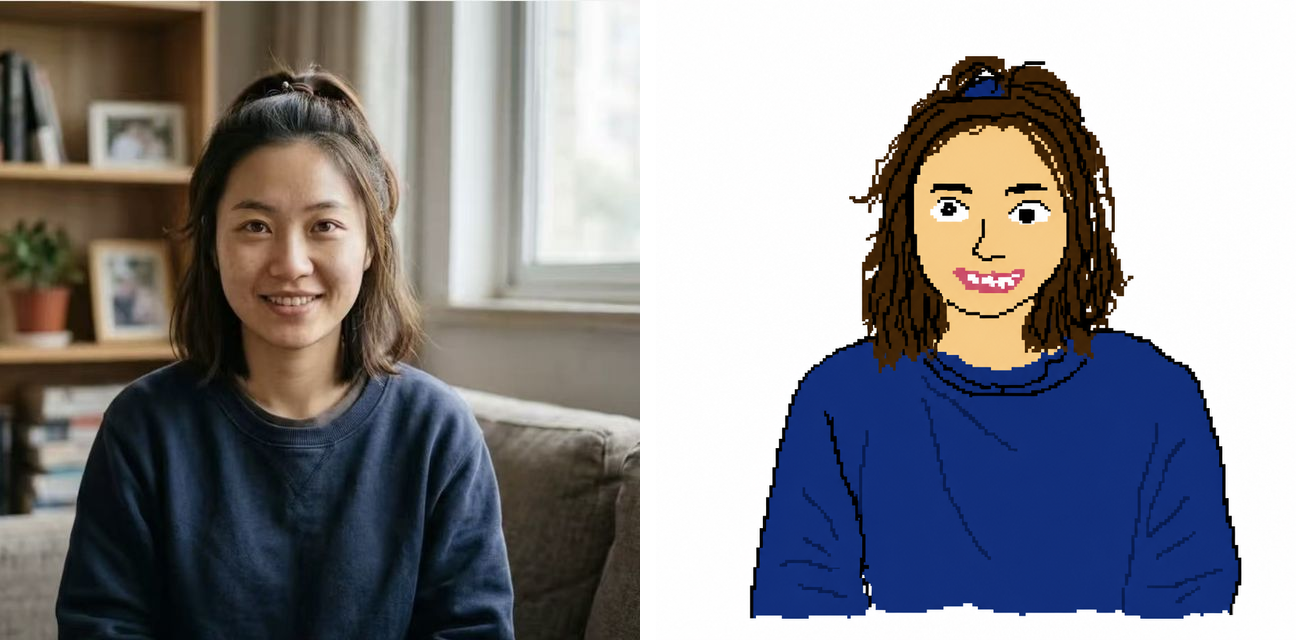
カジュアルな人物写真 → 歯がのぞく落書き
スタジオに馴染む照明の良いカジュアルな人物写真は、モデルに「壊しやすい識別構造」を与えます。髪はモジャモジャの後光に、笑顔は奇妙に歯が出て、背景の本と植物はぐにゃぐにゃの塊に。顔は約 0.5 秒だけ認識でき、その後目が変な位置で固まります。

アクション写真 → ゴム手足の漫画
スポーツや屋外写真は最も笑える結果に。プロンプトが動きの中で手足を比例的に保つ術を知らないからです。スケーターのポーズはおおむね正確に保たれるものの、頭が縮み、肩が膨らみ、背景のスケートパークがぼんやりとしたコンクリートの塊に溶けます。純粋な「呪われた漫画」エネルギー。
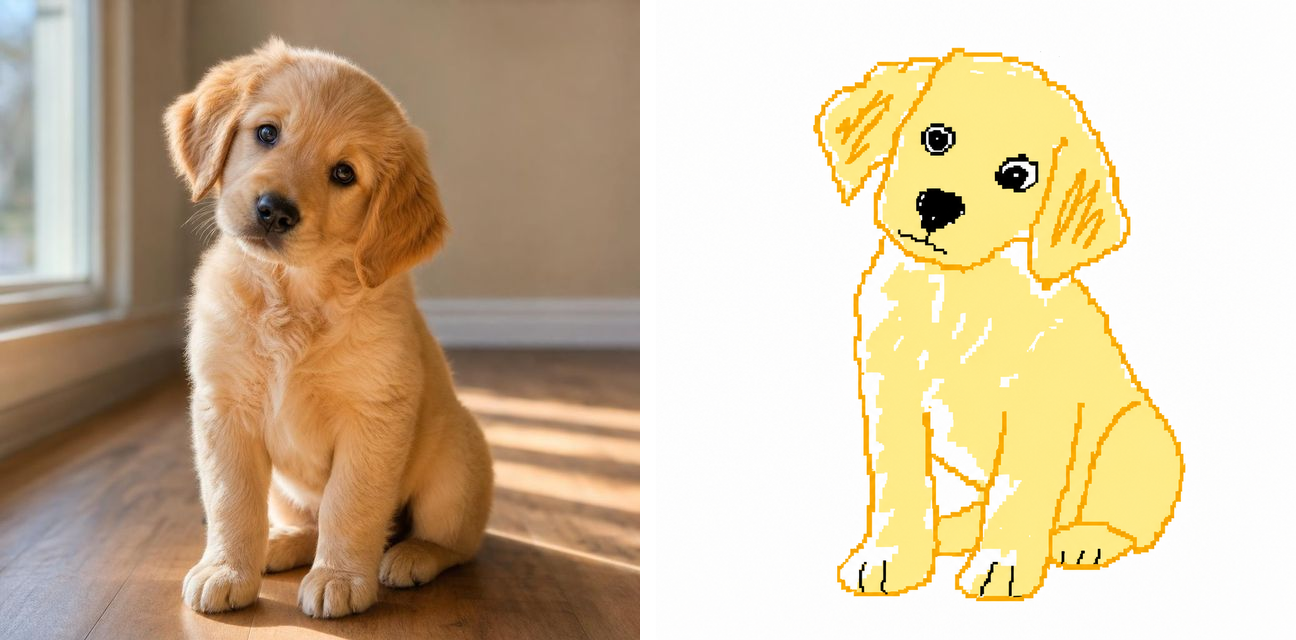
ペット写真 → 小学 4 年生の落書き
動物が(最高の意味で)一番ひどく出ます。モデルは毛・足・比率を諦め、子どもの数学ノート余白の落書きエネルギーを持つ平面マスコットだけが残ります。ペットを描き直して友人に送り返せば、即反応。
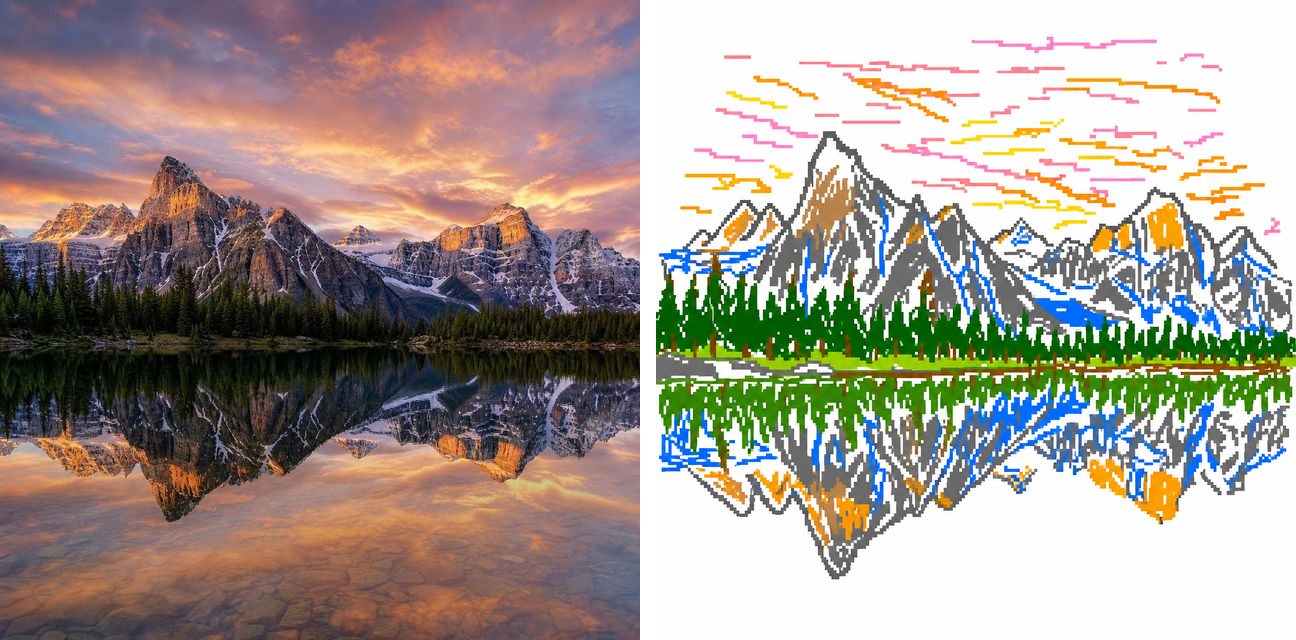
風景 → 8bit ピクセルアート
意外な勝者: 人物のいない風景が元のバイラル美学に最も近い結果に。斜線の雲、落書きの水、ブロック状の山、木のための緑の塊。深さなし・遠近感なし、ただの色と線 — 8bit レトロ風が少し混ざった純粋な MS Paint レンダ感。
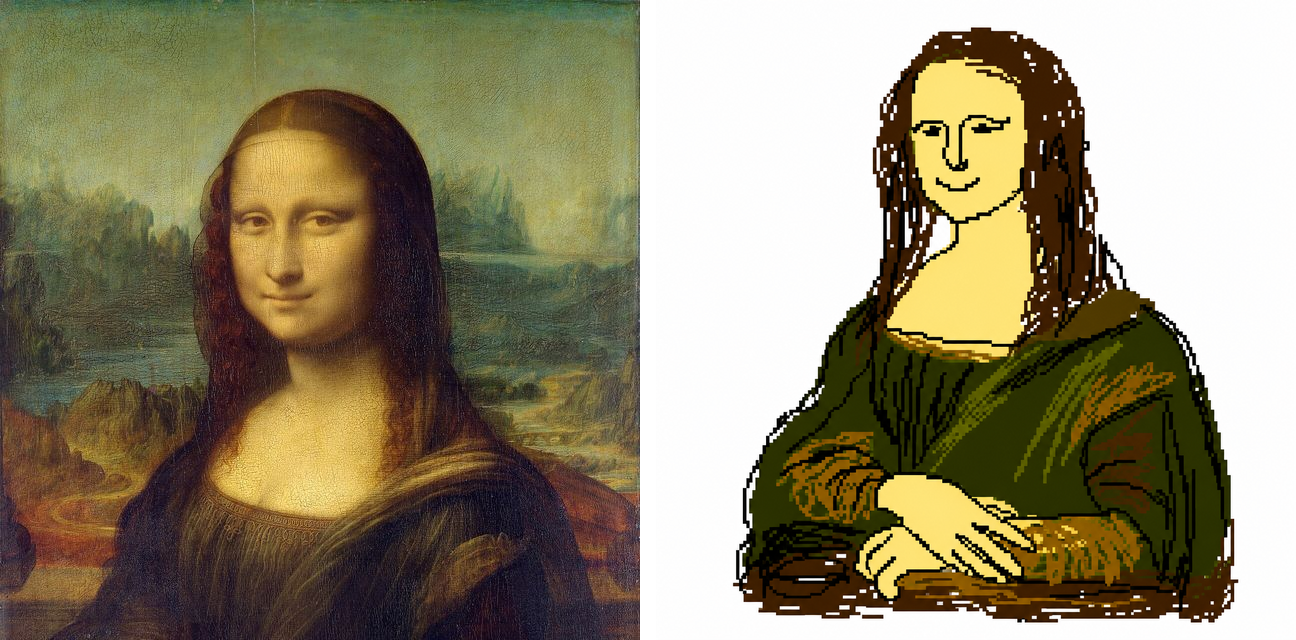
名画 → ミュージアムショップの悲劇
モナ・リザを入れると、GPT Image 2 はポーズ、組んだ手、陰鬱な緑は残しつつ、五世紀分の技巧を投げ捨てます。スフマートの微笑みは平坦なニヤけ顔に、背後の風景は茶色いにじみに。一瞬で分かって一瞬で台無し — どんな名作でも通用するタイプの再描画です。
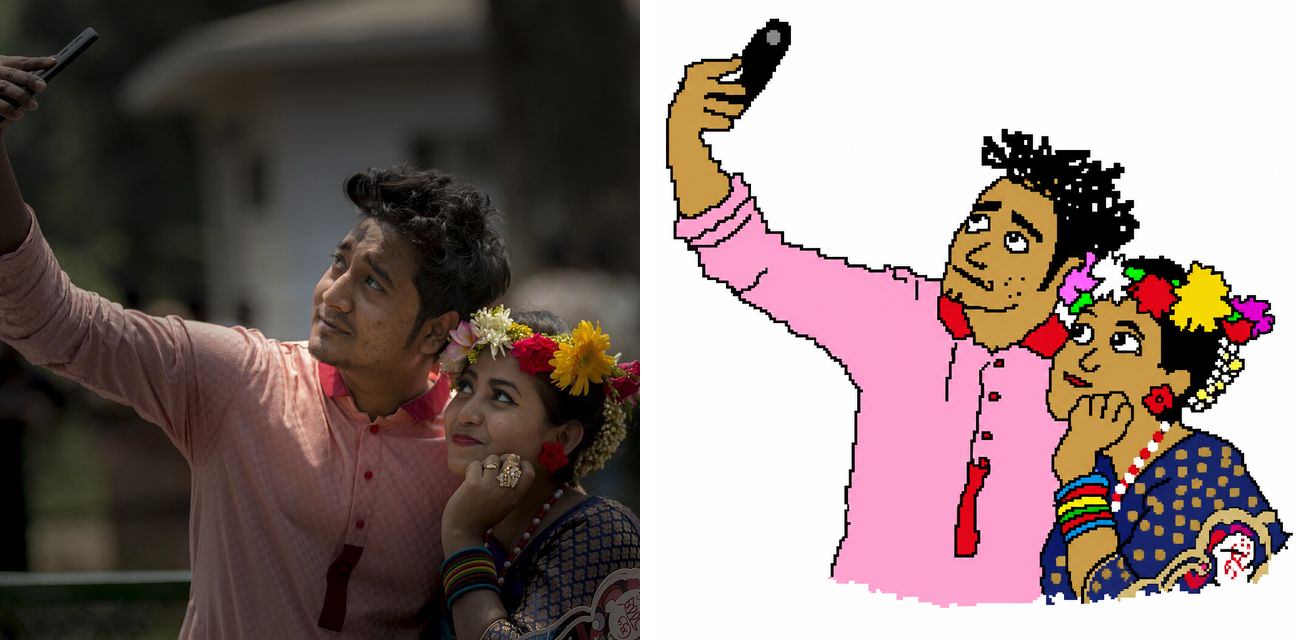
カップル自撮り → ぐにゃぐにゃカートゥーン二人組
本物のカップル自撮り — 片腕を上げてスマホを持ち、もう一人は髪に花を挿して寄り添う — が、ゆがんだカートゥーンの塊二つになって返ってきます。スマホを持つ腕はゴムのように、花飾りは落書きの点の集まりに、二人の顔はあの妙にぎこちない表情に。一緒に撮った相手に送り返すのに最適です。
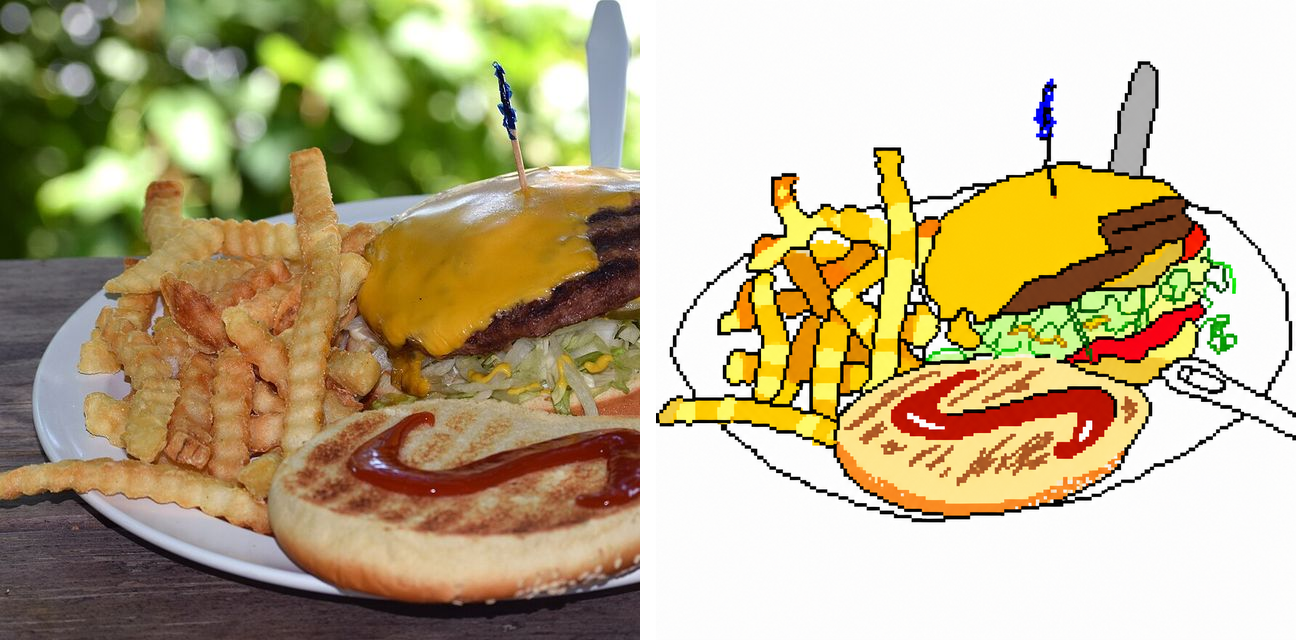
料理写真 → 子どもが描いたメニュー
つやつやのチーズバーガーとフライドポテトの皿が、レモネードスタンドに貼ってありそうな食べ物の絵になります。バンズはツヤを失い、ポテトは黄色い棒に、ケチャップは赤い水たまりに。それでも「バーガーとポテト」だと分かる — その意図と仕上がりのギャップこそが笑いどころです。
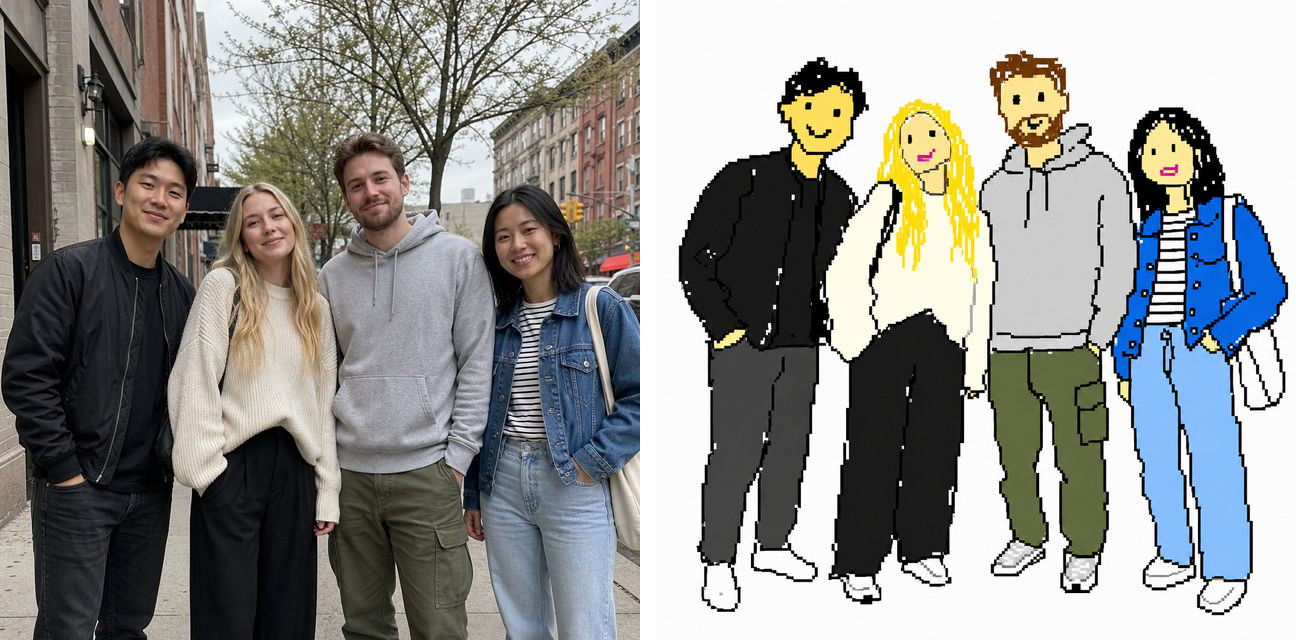
集合写真 → 落書き人間の一団
街角でポーズをとる四人の友人が、棒人間っぽいカートゥーンの一列になります。それぞれ違う落書きヘアに、表情はスマイルの点ひとつ。誰がどこに立っているかはだいたい保ちつつ、全員を同じマヌケな画風に平らにならします — グループチャットで反応間違いなしです。
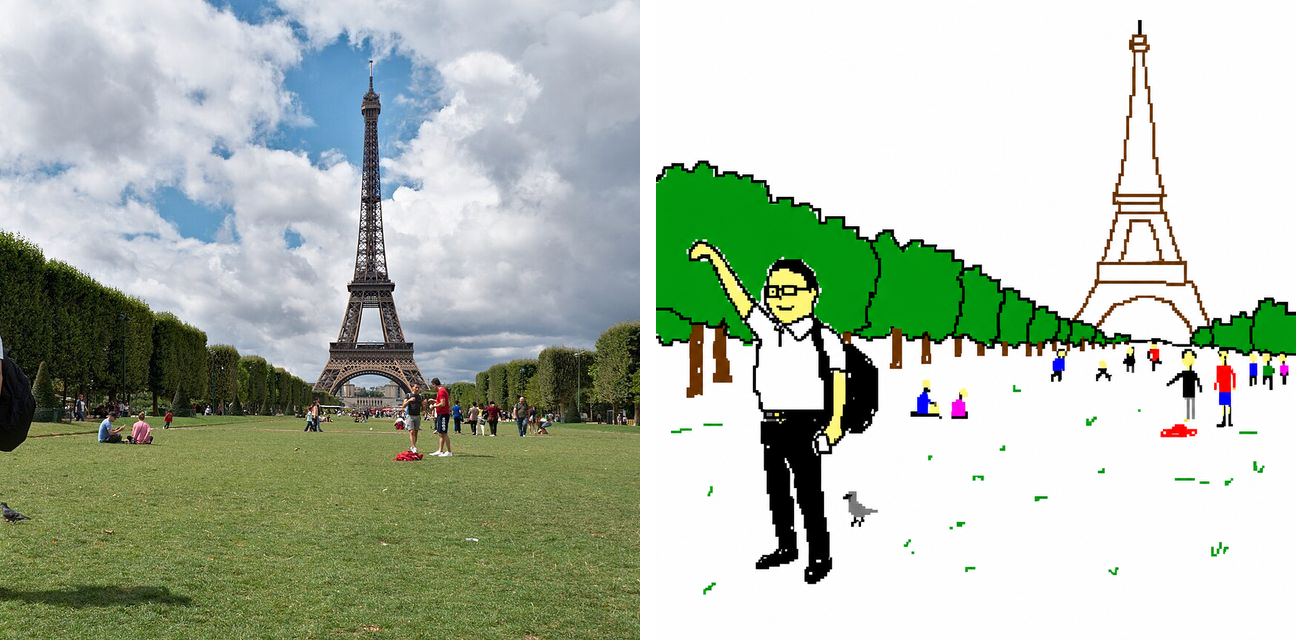
旅行の名所 → 絶対送らない絵はがき
定番の「エッフェル塔をつまむ」観光客ショットが、緑の落書き芝生に立つ棒人間観光客になって返ってきます。背後には傾いた塔。名所は誰もが本来の姿を知っているので特にうまくハマり — それがへたくそ版をさらに面白くします。
ミームを実行するために必要なすべて
1 つの仕事のために設計: 自分の画像でバイラル MS Paint リドローを素早く再現。
ワンクリック設定
ページに到着すると編集フォームは既に image-to-image モードで、バイラルプロンプトがロード済。写真をアップロードして生成を押すだけ。
編集可能なプロンプト
プリセットですがロックされていません。文言を調整したり、「MS Paint」を「クレヨン」「3 歳児の絵」に置き換えたり、自分流アレンジを追加したり — フォームは通常のジェネレーターと同じ。
GPT Image 2 品質
バズった元ネタと同じ OpenAI モデルで実行。模倣モデルなし、「だいたい同じ」なし — 同じエンジン、同じ文言、同じ見た目。
複数画像の一括処理
自分と友人の写真を一度に投入 — エディタは複数の参考画像を受け付け、それぞれの描き直し版が手に入ります。
シェア準備済みダウンロード
出力は SNS サイズに合うクリーン PNG。ツイート・iMessage・Discord にそのまま投下 — 笑いはアップロードに耐えます。
MS Paint リドロー — FAQ
バイラル GPT Image 2 落書きプロンプトに関するよくある質問。その他は support@imagesv2.ai までメールを。
「Redraw the attached image as poorly, doodle-like, and completely pathetically as possible. Use a white background and make it look like it was drawn with a mouse in MS Paint. It should vaguely resemble the original yet not really, somewhat match yet be confusingly off, with that low-quality pixelated feel that really emphasizes how laughably bad it is. Actually, just draw whatever you want.」末尾のカジュアルで投げやりなトーンが、プロンプトが効く理由のひとつ — モデルにきれいに整える必要はない、下手な絵の美学に寄っていいんだ、と許可を与えます。
プロンプトは明示的に「*添付された* 画像を描き直して」と言います — テキスト→画像ではなく image-to-image の指示。アップロードされた参照なしでは GPT Image 2 は描き直す対象がなく、無関係な落書きを生成するだけ。だから本ページは既定で image-to-image モードに落とし込みます。
2 つの出力が同一になることはありません — GPT Image 2 は実行ごとに揺らぎます。*スタイル* は一貫(子どもっぽい・落書き・MS Paint 風・白背景)ですが、具体的な形や色は変わります。最初の結果が十分に笑えなければ再生成を — プロンプト末尾の「whatever you want」が意図的にモデルに自由を与えています。
はい — プロンプトは編集可能。「drawn with a mouse in MS Paint」を「crayon on construction paper」「a 4-year-old's drawing」「notebook margin doodle」などに置換可。構造(描き直し + スタイル指定 + 下手でいい許可)がプロンプトを動かしており、具体的スタイルはあなた次第。
あらゆる GPT Image 2 image-to-image 生成と同じ。正確なクレジット コストはクリック前に生成ボタン上に表示。新規ユーザーは決済なしで試せる無料クレジットを獲得します。
可能。GPT Image 2 の出力は OpenAI の利用ポリシーに従い使用可。標準的なミームや共有用途はその規約の範囲内です。
アップロードは OpenAI のデータポリシーに従い処理のため OpenAI API に送信されます。他のユーザーに公開せず、いかなるモデル学習にも使用しません。自分の写真をアップしたくない場合、ミームはペット・家具・スクリーンショットでも同様に笑えます。
はい。"badly drawn MS Paint"、"clumsy scribbly pathetic prompt"、"MS Paint style image redraw" は、どれも同じバイラル GPT Image 2 トレンド — 普通の写真を意図的にひどいマウス描きの落書きに変えること — を指す呼び名です。本ページはまさにそのプロンプトを実行するので、どの名前で検索しても正しい場所にたどり着いています。
上のプロンプトセクションに表示している GPT Image 2 の指示です — 添付画像を白背景で、できるだけ clumsy・scribbly・pathetic な MS Paint 風に描き直すようモデルに伝えます。ジェネレーターにプリセット済なので、何もコピーせずにそのまま描き直しを実行できます。
自分の写真にバイラル GPT Image 2 プロンプトを実行
新規登録で無料クレジット。画像をアップロードして生成を押すだけ — プロンプトはセット済。
別のツールをお探しですか?
AI 画像ジェネレーター、モデル、変換ツール、写真ツールをすべて一つのページでチェックできます。






